摘要
本博客以循序渐进的方式,依次简要介绍PostgreSQL存储模块的各个子模块的基础功能,提及内容适合数据库内核初学者。本博客旨在介绍核心原理,以便于理解为首,部分内容可能不会100%准确与具体,针对每个提及的子模块,之后会分别单独写博客详细介绍
目录
1 概述
1.1 PostgreSQL的使用流程
本博客仅讨论存储模块的关键原理。简而言之,PostgreSQL将数据合理地组织并存储在磁盘上,并向用户提供SQL接口,让其读写磁盘上的指定数据。以下是PostgreSQL简单工作流程:
安装PostgreSQL
安装前,用户需指定一个空文件夹作为PostgreSQL的数据目录。initdb -D 数据目录 ...安装后,PostgreSQL会在数据目录下生成很多子目录以及文件
启动PostgreSQL
等待用户向PostgreSQL建立连接并发送请求pg_ctl -D 数据目录 ... start连接PostgreSQL
用户连接PostgreSQL后,可向其发送SQL语句,让其执行psql -h 数据库所在机器的ip -p 数据库进程监听的端口 ...执行SQL语句
以常见的SQL语句为例PostgreSQL的执行原理如下:创建表:PostgreSQL接收以下SQL后,在数据目录下生成1个用于存储表t1数据的数据文件
CREATE TABLE t1 (c1 INT, c2 TEXT);写数据:PostgreSQL接收以下SQL后,将SQL语句中的数据(1, ‘data1’)写入上一步创建的t1数据文件
INSERT INTO t1 VALUES (1, 'data1');读数据:PostgreSQL接收以下SQL后,从t1的数据文件中,读取数据,并发送给用户
SELECT * FROM t1;
1.2 PostgreSQL的基础架构
1.3 PostgreSQL的功能场景
用户使用数据时,有很多复杂的场景,因此,在解决组织与存储数据的问题时,数据库还需考虑:
- 多数据:一些场景中,1个数据库集群,可能存储上万张表,部分表中可能存储上百亿条数据,1个表的总数据大小可能为几T
- 多操作:1个表上,可能会执行INSERT、DELETE、UPDATE、SELECT等操作,在组织数据时,还需考虑数据的变化问题,比如,利用被删除数据原先所占的存储空间
- 高并发:一些场景中,用户可能有上百个事务,同时操作1个表,在表上并发进行INSERT、DELETE、UPDATE、SELECT等操作,需要考虑各种操作的并行与互斥
- 高性能:用户读写数据时,最终目的是读写磁盘上的表文件,高并发场景,磁盘IO频率等关键因素,对性能影响较大
- 高可靠:
- 高可用:
1.4 PostgreSQL存储模块的介绍流程
2 执行模块
占个位先,以后介绍执行模块
3 存储模块
3.1 存储结构
(1) data_directory
安装数据库时,要求指定数据目录$data_directory
export data_directory=随便设置个目录
initdb -D $data_directory
执行initdb后,$data_directory目录下会生成很多文件
ll $data_directory

    $data_directory # 暂时忽略每个文件夹或文件的代表什么,只需知道文件夹和文件很多即可
        |-- base
        |-- global
        |-- pg_wal
        |-- pg_xact
        |-- PostgreSQL.conf
对于已安装的数据库,在psql中,通过如下命令,可查看$data_directory
show data_directory;
            data_directory
---------------------------------------
 /path/to/data_directory/
(2) oid
PostgreSQL会为每个对象分配一个唯一的id,即oid。每个Database、Table等很多对象都有一个唯一的oid。oid的用途很大,后面会提到。
举例:
CREATE DATABASE db1;
CREATE TABLE t1 (c1 INT);
CREATE TABLE t2 (c1 INT);
-- db1, t1, t2都有一个唯一的oid,比如,分别是16386, 16387, 16389
通过以下语法,可从系统表中找到表对应的oid
SELECT relname,oid FROM pg_class WHERE relname = 't1';
 relname |  oid
---------+-------
 t1      | 16387
(3) data-file
用户创建的表时,PostgreSQL会在数据目录下,生成1个对应的data-file文件,用于存储表中数据
举例:
CREATE TABLE t1 (c1 INT); -- 假设t1的oid为16387,t1属于名为db1的database,db1的oid为16386
刚创建表时,由于表中暂时无数据,因此文件也暂时是空的。文件名默认为表的oid,在数据目录下,可找到对应的文件。
$data_directory
    |-- base
        |-- 16386     # 文件夹为database的oid
            |-- 16387 # 文件名为table的oid
通过以下语法,可从系统表中,看表对应的data-file的绝对路径:
SELECT setting || '/' || pg_relation_filepath('t1') FROM pg_settings WHERE name = 'data_directory';
                       ?column?
-------------------------------------------------------
 /path/to/data_directory/base/16386/16387
(1 row)
一些特殊情况,例如vacuum full语法,会重建表对应的data-file文件,此时,data-file文件的名称可能会与表的oid不一致,但是,无需担心,数据库会记录表oid和文件名的对应关系。
特殊情况(暂不考虑):
- Toast表:如果1条数据的长度超过2k,且是Text等类型,超长数据可能存储在不同文件中,详见Toast机制
- 大数据量:如果向1个表写入狠多数据,该表对应的数据文件大小达到1G时,该表会生成第2个数据文件来存数据。依次类推,表中数据量较大时,1个表可能有很多个数据文件。1个表最多可拥有32T的数据文件
- 分区表:如果创建分区表,每个分区的数据文件都是独立的。本博客不关心分区表
- 段页式表:如果1个表对应1个或多个文件,当表的数量过多时,文件的数量也很多,Oracle支持将多个表的数据存储在同1个文件中,以缩减文件数量。本博客不关心Oracle
(4) page
当执行以下语法,向表中插入数据时,(1, 'data1')是表中1行数据,这个行数据将被写入表对应的data-file中。
INSERT INTO t1 VALUES (1, 'data1');
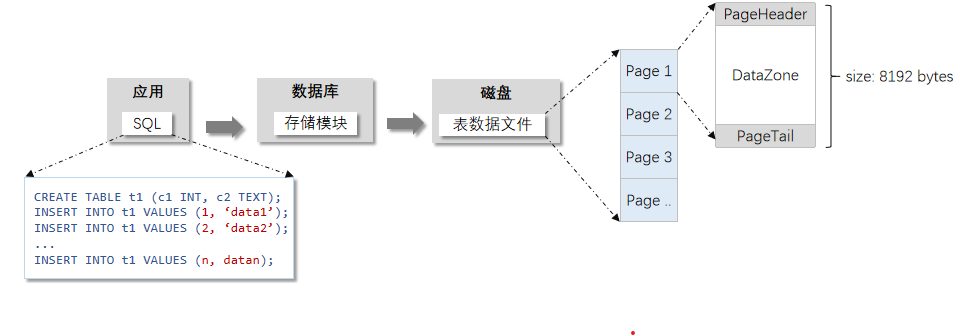
1个data-file,由1个或多个数据页(page)组成:
- page大小:所有Page大小一致,均为8192字节,即8k。因此,1个data-file的大小,始终是8k的整数倍
- page组成:1个page,由3个部分组成:
- PageHeader:通常为几十字节,存储page的空闲空间等很多信息
- DataZone:存储行数据,即page的关键区域
- PageTail:通常为0/几十/一两百字节,大部分data-file无PageTail,暂时忽略,后文介绍
- page规律:最开始时,1个data-file有1个page,可存储多行数据。1个page存满后,会生成新的page存数据,以此类推,数据越多,page越多
操作系统从文件读取数据时,每次固定读取4k,即1个file-block,请仔细了解该机制的目的
PostgreSQL每次从磁盘读取文件时,每次读取1个page,page大小默认为8k,还可配置为4k, 16k
(5) tuple
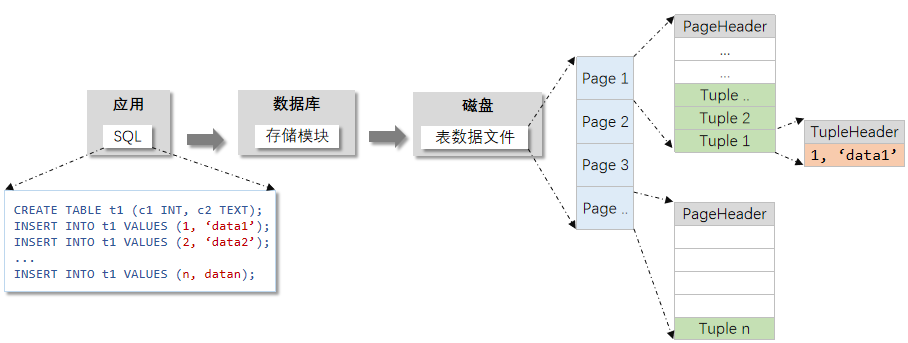
1个page中,DataZone由多个tuple组成:
- tuple大小:1个tuple,用于存储1行数据,行数据越长,tuple越长。(如果行数据超过2k,可能触发toast机制,后文才介绍该机制)
- tuple组成:1个tuple,有2个部分组成:
- TupleHeader:通常为几十字节,存储行数据的状态等信息
- Data:即行数据本身
- tuple规律:用户每插入1条行数据,生成1个tuple,Tuple存放在page的DataZone区。1个page存满,会生成新的page,新tuple也将存放在新的page,以此类推
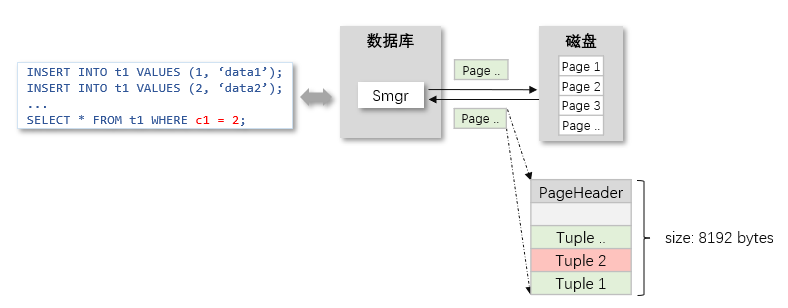
在page中,tuple是从后往前排列的,即从PageTaile方向逐渐往PageHeader方向排列。上文提到,大部分data-file的page中,无PageTail,因此,下图中暂时省去PageTail
3.2 关键机制
(1) mvcc
PostgreSQL的高并发场景
实际应用场景中,1个数据库,可能需要同时处理成百上千个事务,这些事务,可能会访问同一个表,产生很多访问冲突的问题。以下是一个简单的示例:-- 用户1,执行事务1,事务尚未提交 BEGIN; INSERT INTO t1 VALUES (1, 'data1'); -- 用户2,执行事务2 BEGIN; SELECT * FROM t1 WHERE c1 = 1; -- 此时,同一时间,有2个执行中的事务,同时访问 t1表PostgreSQL事务的特点
上述示例中,事务2会和事务1发生访问冲突,数据库有不同的事务隔离级别(其他文章会详细介绍),以默认的隔离级别为例,事务2应该有以下2个特点:- 即使事务1没有提交事务,事务2也可以访问t1表,无需等待
- 事务1的数据
(1, 'data')还未提交,事务2应无法访问(1, 'data'),即该条数据对事务2不可见
PostgreSQL事务的原理
为了解决并发访问问题,PostgreSQL使用MVCC机制,该机制的基本实现原理如下:- 标识事务顺序:PostgreSQL维护一个递增的数字,即事务id,每个要写数据的事务,都会申请1个事务id。先开始的事务,id小,后开始的事务,id大
- 维护事务状态:PostgreSQL会维护所有正在进行中的事务的状态
- 记录数据版本:事务写入数据时,即将行数据封装到tuple时,会在tuple的头部记录事务id,即每行数据都携带了事务id
- 检查数据版本:每当PostgreSQL访问行数据时,会先从tuple的头部获取事务id,再检查全局事务状态,判断该条行数据是否可访问
(2) delete
上文提到,PostgreSQL经常需要处理高并发场景,比如,一个事务删除数据时,另一个事务读取数据,以下是一个简单的示例:
-- 用户1,执行事务1,删除数据,事务尚未提交
BEGIN;
DELETE FROM t1 WHERE c1 = 1;

-- 用户2,执行事务2
BEGIN;
SELECT * FROM t1 WHERE c1 = 1;

-- 此时,同一时间,有2个执行中的事务,同时访问 t1表,1个事务删除数据,1个事务读取数据
- PostgreSQL删除数据的流程
在示例中,显然,当事务1执行DELETE操作时,由于事务未提交,显然不能直接从Page中删除数据。PostgreSQL采用标记删除的方法,标记删除的基本原理如下:- 记录数据状态:删除数据时,先将数据标记为删除状态,并在tuple的头部记录删除tuple的id
- 检查数据版本:当其他事务访问到含删除标记的tuple时,从tuple的头部获取事务id,检查事务id对应的事务是否已提交,如果对应的事务未提交,该条tuple仍然可见或者暂时无法操作
- 清理无效数据:执行删除操作的事务提交后,代表含删除标记的tuple真正变成无效数据,但是,考虑到性能等因素,PostgreSQL不着急立即清理无效的tuple,而是提供一些异步清理的机制,后文会介绍
3.3 执行流程
(1) input
首先,此处以一个简单的例子,介绍在处理SQL语法的整个流程中,存储模块主要完成哪些工作:
用户:执行以下SQL
INSERT INTO t1 VALUES (1, 'data1');执行模块:直接包括语法解析、语义分析等流程后,最终,获取3个最关键的的信息:(1) 执行INSERT操作,(2) 表名为 t1,(3) 行数据为 (1, ‘data1’),然后,调用存储模块的接口,将表的信息,行数据本身传递给存储模块
存储模块:存储模块将行数据(1, ‘data1’)封装到tuple中,然后从t1对应的data-file中,找到合适的page,将tuple存入page。在完成这些功能的同时,考虑高并发、高性能、高可靠等因素
用户执行INSERT、UPDATE、DELETE、SELECT等很多操作时,都需要调用存储模块的接口,不同操作的接口不同,本章主要以INSERT语法为例,简单存储模块处理INSERT语法时,会涉及哪些子模块,以及模块的基本功能。存储模块处理其他语法时,基本流程、涉及的子模块、子模块的功能等都大同小异,便不一一介绍。
在PostgreSQL的代码中,1个relation结构体,存储1个表的基本信息。例如,用户执行以下语法:
INSERT INTO t1 VALUES (1, 'data1');
上述INSERT语法中,执行模块识别到表名为t1时,会生成1个relation结构体,然后将表的众多关键元信息暂存在relation结构体中,比如表oid、表的列数、表的列数据类型等,这些元信息大部分来自系统表,例如,上文提到的pg_class等系统表。当然,ralation也会暂存一些其他临时数据,比如,表上的锁等。
在代码中,无论是执行模块,还是存储模块,都会经常用到relation结构体中的信息。执行模块调用存储模块的接口时,也会直接将relation结构体传到存储模块。
(2) heapam
heapam是存储模块对上层提供的数据读写接口的模块,通常由执行模块调用。这些接口通常是操作1个relation中的1个或多个tuple。即操作1个表中的1行或多行数据。可以理解为,heapam是存储模块的入口。
本文介绍heapam模块最常见的4个接口,用户执行INSERT、DELETE、UPDATE、SELECT等语法,操作表时,执行模块通常调用以下4个接口:
/*
 * 功能:向relatiion中写入1条tuple
 * 示例:用户执行 INSERT INTO t1 VALUES (1, 'data1');
 *      relation中存储 t1 的原信息,比如oid等
 *      tup中存储1行数据 (1, 'data1'),此时的HeapTuple,主要包含数据,tuple的头部中还没有事务id等信息
 */
heap_insert(Relation relation, HeapTuple tup, ...)

/*
 * 从relation中删除1条tuple
 * tid存储要删除数据的位置,tid中的关键信息为:哪个data-file, data-file中第几个page, page中第几个tuple
 * 执行模块会调用其他存储接口,找到要删除tuple的位置,此处暂不介绍
 *
 * 示例:用户执行 DELETE FROM t1 WHERE c1 = 1;
 *      tid为符合条件c1=1的行数据的位置,如果有多条符合条件的行数据,存储模块会调用多次heap_delete,每次调用仅删除1个tuple
 */
heap_delete(Relation relation, ItemPointer tid, ...)

/*
 * 在relation中,将旧tuple标记删除,并写入1个新tuple。后文会介绍此处的标记删除机制
 */
heap_update(Relation relation, ItemPointer otid, HeapTuple newtup, ...)

/*
 * 从relation中读取数据,每次读取1条数据
 */
HeapScanDesc heap_beginscan(Relation relation, ...)
HeapTuple heap_getnext(HeapScanDesc scan)
(3) trancation
上文提到,为解决高并发等问题,PostgreSQL在tuple中存储行数据时,会同时存储事务id。执行模块调用heap_insert时,只传递了行数据,因为,在heap_insert函数内部,会首先执行以下2个操作:
- 申请1个事务id,代表此次执行INSERT操作的事务
- 生成1个tuple,在tuple的头部记录事务id,在tuple中存储行数据
至此,已准备好1个完整的tuple
(4) fsm
生成tuple后,需要找到1个合适的page,将tuple存放到page中
寻找合适的page时,考虑:
- tuple长短不一:1个表有多个page,1个page可存储多个tuple,1个tuple存储1行数据,数据来自
INSERT .. ('data')等语法,语法中的数据长短不一,有的数据长度可能为0.1k,有的数据长度可能为1k - page空闲不一:如果执行
DELETE等操作,某些page中的某些tuple可能跟被删除,数据的异步清理机制可能会清理page中的tuple,导致page中空闲空间变大 - page数量很多:一些场景中,1个表可能存储几T的数据,即data-file中的page数非常多
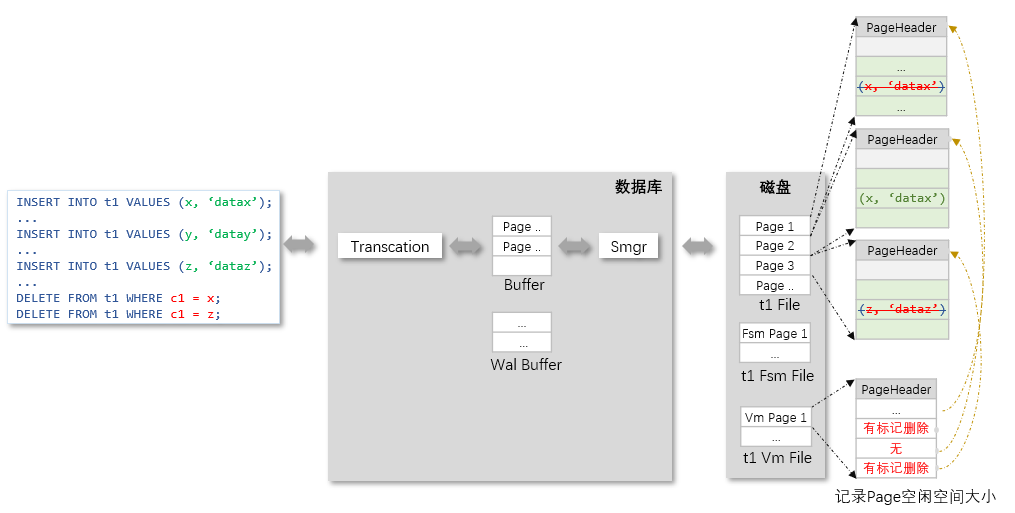
fsm模块的功能是记录每个page的空闲空间大小,并根据tuple的长度,提供快速查1个具有合适空闲空间的page的功能
- fsm文件:为了记录page的空闲空间,1个表,除了拥有1个data-file存储数据外(暂不考虑数据量超大场景),还拥有1个对应的fsm-file。fsm-file存储data-file中每个page的空闲空间大小,假设data-file的名称为17000,则对应fsm-file的名称为17000_fsm
- fsm内容:对于data-file中的所有page,即第1,2, 3, …个page,fsm-file中只会分别记录1个整数,表示对应page中空闲空间大小
- fsm查找:fsm-file的大小远远小于data-file的大小。向data-file写入tuple之前,先快速从fsm中查找具有合适空闲空间的page,然后直接获取该page
- fsm组织:1个fsm节点记录1个page的空闲空间,所有fsm按照空闲空间大小的顺序,组成棵个b+树,提高查找效率
(5) buffer
选择page后,从磁盘读取page时,io开销很高,为了提高性能,存储模块会在内存中缓存一些经常访问的page,降低io次数
缓存page时,需考虑:
- page数量很多:上文提到,1个数据库有很多表,1个表有很多page,磁盘上page的总大小,可能是T级别的,而内存大小,一般是G级别,因此,只能缓存少部分page
- 快速查找page:fsm每次选择page后,首先需判断page是否存在于缓存中,要遍历缓存中的page,显然查找速度很慢,因此,需提高page查找速度
- page访问随机:内存只能缓存少部分page,而用户执行SQL时,短时间内访问的page数绝对大于内存中缓存的page数,因此,需制定缓存page淘汰机制
- page并发访问:在缓存中的page,可能被多个事务访问,因此,需对缓存中的page加锁访问
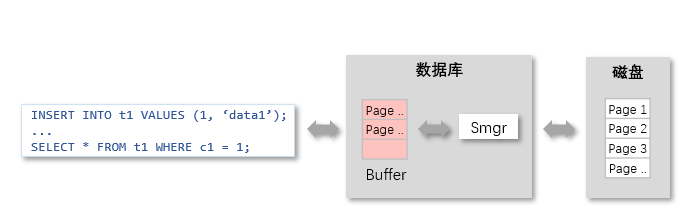
buffer模块的功能是缓存page,并解决快速查找、并发访问等问题,无论是读还是写page,都优先从buffer中查找page:
- buffer容量:根据每台机器内存大小、数据库配置参数等不同,buffer模块可缓存的page数也不同,一般是几千个page
- buffer查找:buff中,所有page存在1个hash表中,每次查找page时,根据2个关键信息,[data-file对应的id, data-file中第几个page],作为key值,可找到唯一的page
- buffer插入:每次读或写page时,先在buffer中查找page,如果指定page不在buffer中,则从磁盘读取指定page,然后将page插入buffer中
- buffer淘汰:随着page不断插入buffer,当buffer缓存快慢时,buffer会依据最近每个page的访问次数的依据,淘汰一些page
- buffer落盘:当事务向buffer中的page写数据时,此时buffer中的page与磁盘上对应的page内容已不一致,即buffer中的page时脏页,为了提供读写效率,事务并不会立即将脏页落盘,后文会介绍buffer中脏页异步落盘的机制
- buffer并发:buffer中的每个page,都有对应的读写锁,控制多事务对同一page的并发访问
(6) smgr
从磁盘读取page时,1次读写1个page,本质是调用操作系统的文件读写接口read(), write(),设置读写偏移为8k的倍数、读写长度为8k
smgr模块简单封装了操作系统的read/write接口,上层只需传入page的编号,即可直接读写指定page,smgr的接口定义如下:
/* 1 创建或打开1个文件, rnode和文件路径和文件名有关,以后介绍 */
.. smgropen(RelFileNode rnode);
/* 2 向文件中写入1个Page。其中,blocknum即Page编号,从1开始的整数;buffer即长度为8k的Page数据 */
smgrwrite(.., BlockNumber blocknum, char *buffer, ..);
/* 3 从文件中读取1个Page。其中,blocknum即Page编号;buffer即用于存放Page的长度为8k的缓存区 */
smgrread(.., BlockNumb blocknum, char *buffer);
/* 4 其他之后介绍 */
另外,针对不同操作系统场景,smgr模块也可以封装不同操作系统的不同文件读写提供,对上层提供统一的接口。
(7) vfd
从磁盘读取page时,需确保文件已打开,即获取文件句柄
获取文件句柄时,需考虑:
- 句柄数量多:在linux中,1个进程,一般最多可同时打开几千个文件,但PostgreSQL是频繁读写文件的进程,1个数据库中,可能拥有上万个文件,因此,需解决数据库文件数大于单进程文件句柄数的限制
- 句柄访问随机:与buffer模块的原理类似,当句柄较多时,还需考虑句柄淘汰的问题
vfd模块的功能是缓存最近常用的句柄,当句柄数达到操作系统限制时,淘汰暂未被使用的句柄,确保打开新文件时,不会因达到操作系统句柄数限制而失败
(8) vm
向page写入tuple后,写入tuple的事务仍未提交,写入事务可能回滚,导致tuple失效,而且,写入事务未提交前,对于其他事务而言,该tuple并未生效。从page中删除tuple时,tuple也会失效。PostgreSQL需异步清理page中的失效tuple。
清理各page中未生效的tuple时,需考虑:
- page数量很多:上文提到,1个data-file中的page数可能非常多,清理
- page无无效tuple:1个page中,可能所有tulpe都是有效的,即无事务删除任何tuple、且所有插入tuple的事务也提交了等,此时,无需清理page
vm模块的功能是记录每个page是否含未生效的tuple,并提供快速判断指定page是否含未生效的功能
- vm文件:为了记录所有page是否含未生效的tuple,1个表,除了拥有1个data-file文件,1个fsm-file外,还拥有1个对应的vm-file。vm-file存储data-file中每个page中是否含未生效tuple。假设data-file的名称为17000,则对应vm-file的名称为17000_vm
- vm文件内容:对于data-file中的所有page,即第1,2, 3, …个page,vm中只会分别记录1个bool值,表示对应page中是否含未生效tuple
- vm文件查找:fsm-file的大小远远小于data-file的大小,在异步清理无效tuple时,先快速从vm中判断指定page是否含含未生效tuple,便无需读取所有page,降低IO次数。另外,后文会提到,vm模块对索引模块也很重要
- vm文件组织:vm文件本质是一个数组,数组的下标表表示对应page的编号
(9) wal
将tuple插入page后,page暂时在buffer中。存储模块需要在确保高可靠和高性能的前提下,将tuple落盘
将tuple落盘时,需要考虑以下问题:
- 高可靠:数据库是对可靠性要求极高的软件,当插入tuple的事务提交时,如果tuple未落盘,当发生断电等突发事件,内存即buffer中的tuple将会丢失,重启后,将出现事务提交,但是事务插入的tuple丢失,数据不一致
- 高性能:1个事务,可能将多个tuple,插入多个page。在事务提交前,如果依次将每个page都落盘,由于IO开销较高,将导致单个事务的处理时间变长,整体性能较低
- 高可用:数据库对可用性要求也极高,大部分场景,都需同时部署主、备数据库,当主数据库发生故障时,备数据库需升为主数据库,保证服务不中断,此时,要求主机源源不断往备机发送数据,并且保证,事务提交时,备机已成功接收与落盘数据。如果主机往备机发送SQL语句,备机接受和执行SQL语句,显然效率很低
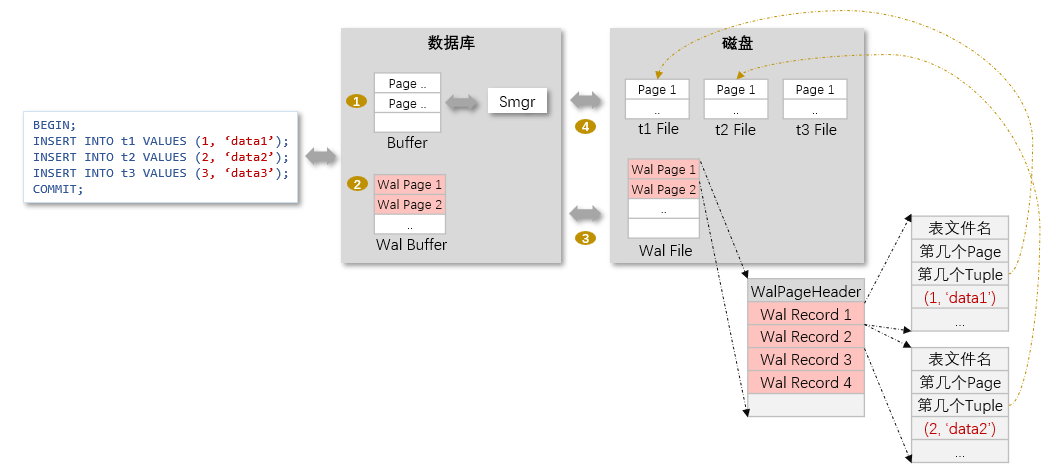
wal模块的功能是收集所有文件写操作、写操作的信息、写操作涉及的数据,1写操作记录到1条wal-record中,当事务提交时,确保事务所有写操作生成的所有wal-record都落盘。示例:
用户执行事务
BEGIN;
INSERT INTO t1 VALUES (1, ‘data1’);
INSERT INTO t2 VALUES (2, ‘data2’);
INSERT INTO t3 VALUES (3, ‘data3’);
存储模块执行写操作
- 执行3次heap_insert,分别生成3条tuple,将3条tuple存入3个page,3个page暂存在buffer中
- 假设生成tuple-1, tuple-2, tuple-3,分别被写入data-file-1, data-file-2, data-file-3的page-1, page-2, page-3
用户提交事务
COMMIT;存储模块执行事务提交
- 假如无wal模块:存储模块先将page-1, page-2, page-3落盘,再向用户返回事务提交成功
- 假如有wal模块:
- 生成wal-record:将3条tuple存储3个page的同时,生成3条wal-record,3条wal-record记录的关键信息分别为[insert, data-file-1, page-1, tupl-1, tuple-offset], [insert, data-file-2, page-2, tupl-2, tuple-offset], [insert, data-file-3, page-3, tupl-3, tuple-offset]
- 落盘wal-record:3条wal-record可组合在一起,落盘1次即可
- 发送wal-record:由于wal-record记录了所有关键信息,备机接受wal-record后,直接根据元信息重现主机的写操作即可,无需重复分析处理SQL,甚至,备机确保接收的wal-record落盘即可,无需在事务提交时立即重现写操作(实际上,执行1次事务,写文件的次数,文件的类型等,远超此处的示例)
- 最后,返回事务提交成功
wal模块的上述机制,对关系数据库非常重要,几乎存在于所有关系数据库中
(10) wal-buffer
生成wal-record后,需要将wal-record写入磁盘。