目录
1 基本概念
1.1 业务场景
场景一:数据共享(异构数据库)
1个公司,有2个部门:商品库存部门、商品成本部门。2个部门有不同技术栈,使用不同数据库产品:postgresql、mysql。2个部门需共享相同的表:商品信息表。场景二:数据容灾
应用存储数据时,同时将数据存储至postgresql于mysql中,避免某款数据库出现无法恢复的数据损坏问题。场景三:版本升级
从postgresql 13版本,升级到postgresql 16版本。场景四:数据迁移(异构数据库)
从postgresql,将数据库迁移到mysql中。
1.2 逻辑复制
从一个数据库中,将针对指定表的insert、delete、update等写操作,复制到其他另一个数据库、工具等。
复制该场景中,有2种角色:
- 发布端:发送端
- 订阅端:接收端
1.3 实现思路
此处,以postgresql为例,逻辑复制实现思路如下:
上图中,关键流程如下:
- 执行sql:应用执行insert、delete、update等语句
- 生成wal:postgres进程执行sql,生成wal,将wal写入文件
- 发送wal:如果启用逻辑复制,发布端会启动一个用于逻辑复制的wal-sender进程,读取wal,将wal解码为logical-wal,并将logical-wal发送给订阅端
- 重放logical-wal:订阅端将logical-wal当做单条insert、delete、update语句执行
1.4 基本概念
逻辑复制大致流程,与物理复制类似。不过,在复制流程中,差异也很多,以上图为例,关键差异如下:
- 物理复制
- 复制粒度:实例产生的所有wal
- 发送数据:wal
- 发送粒度:流
- 回放数据:回放wal
- 逻辑复制:
- 复制粒度:指定的一个或多个用户表,或者表中符合指定过滤条件的数据
- 发送数据:logical-wal。针对一个写操作,会发送一条对应的logical-wal,即一条message。message中的关键内容包括:操作、数据。
- 示例1:
- 执行sql:
INSERT INTO t1 VALEUS (1, 'data1') - 生成wal:
[1] [1800 1810 0 1 ..] [1, 'data1'] ...。格式为:操作类型、filenode、数据等- 格式:
- 发送logical-wal:
[I] [1, 'data1']
- 执行sql:
- 示例2:
- 执行sql:
DELETE FROM t1 WHERE c2 = 'data1' - 生成wal:
[3] [1800 1810 0 1 ..]。格式为:操作类型、filenode等 - 发送logical-wal:
[D] ['data1']
- 执行sql:
- 示例1:
- 发送粒度:默认情况下,是一个完整事务包含的多条message
- 回放数据:apply logical-wal。提取logical-wal中的操作与数据,调用heapam层接口。示例:
- 示例1:
- 接收logical-wal:
[I] [1, 'data1'] - 回放logical-wal:heap_insert
- 接收logical-wal:
- 示例2:
- 接收logical-wal:
[D] ['data1'] - 回放logical-wal:heap_beginscan、heap_delete
- 接收logical-wal:
- 示例1:
2 使用方法
2.1 发布端:配置参数
修改wal级别,多存储一些信息
echo "wal_level=logical" >> $PGDATA/postgresql.conf配置身份认证非核心参数
echo "max_replication_slots=4" >> $PGDATA/postgresql.conf
echo "max_wal_senders=4" >> $$PGDATA/postgresql.conf
echo "max_logical_replication_workers=32" >> $PGDATA/postgresql.conf
echo "listen_addresses='*'" >> $PGDATA/postgresql.conf

sed -i '1i host all all 0.0.0.0/0 md5\n' $PGDATA/pg_hba.conf
echo "host replication all 0.0.0.0/0 md5" >> $PGDATA/pg_hba.conf
发布端:重启参数生效
2.2 发布端:创建发布
创建表
CREATE TABLE pt1(c1 INT,c2 TEXT);
CREATE TABLE pt2(c1 INT, c2 TEXT);
创建发布信息
指定哪些表需要复制。CREATE PUBLICATION pub1 FOR TABLE pt1,pt2;创建复制槽
存储复制状态:wal的位置。
存储数据格式
SELECT pg_create_logical_replication_slot('pslot1', 'pgoutput');
创建用户:订阅端通过该用户连接发布端,以进行数据传输
CREATE USER pu1 REPLICATION SYSADMIN LOGIN ENCRYPTED PASSWORD 'pu1.12345';
GRANT ALL ON pt1,pt2 TO pu1;
2.3 订阅端:创建订阅
创建表
与发布端保持一致CREATE TABLE pt1(c1 INT,c2 TEXT); CREATE TABLE pt2(c1 INT, c2 TEXT);创建订阅信息
CREATE SUBSCRIPTION sub1
    CONNECTION 'host=127.0.0.1 port=5432 dbname=pubdb user=pu1 password=pu1.12345'
    PUBLICATION pub1
    WITH (create_slot = false, slot_name = 'pslot1', copy_data = true);
订阅端自动启动apply-worker进程,与发布端建立连接,接收发布端的logical-wal,并回放logical-wal。
3 核心设计
3.1 整体架构
逻辑复制架构中,有3类角色:
- 应用:发送sql
- 发布端:执行sql,生成wal,解码wal生成logical-wal,发送logical-wal
- 订阅端:接收logical-wal,回放logical-wal
以2个事务并发执行sql为例,在发布端,关键进程为wal-sender。在订阅端,关键进程为apply-worker。
3.2 工作流程
以下是一个典型场景的大致流程:
- 步骤1-9:发布端接收客户端连接,接收与执行sql
- 步骤10-28:订阅端启动实例,检查订阅信息,与发布端建立连接并进行逻辑复制
[发布端]                                                                                        [订阅端]

postmaster        postgres                     wal-writer    wal-sender              wal-file   postmaster             apply-launch                apply-worker
+-------------------+------------------------------+------------+---------------------------+---+---------------------------+---------------------------+----------------------+
| 1 receive connect |                              |            |                           |   |                           |                           |
| 2 fork postgres ->|                              |            |                           |   |                           |                           |
|                   | 3 receive sql                |            |                           |   |                           |                           |
|                   |   delete .. t1 .. c1=10      |            |                           |   |                           |                           |
|                   | 4 scan tuple from t1         |            |                           |   |                           |                           |
|                   | 5 get tuple pointer          |            |                           |   |                           |                           |
|                   | 6 mark tuple deleted         |            |                           |   |                           |                           |
|                   | 7 generate wal               |            |                           |   |                           |                           |
|                   |   type=delete,xid=11         |            |                           |   |                           |                           |
|                   |   filenode=1700,offset=8-3   |            |                           |   |                           |                           |
|                   |   data='10',column=1         |            |                           |   |                           |                           |
|                   | 8 copy wal to wal-buffer --->|            |                           |   |                           |                           |
|                                                  | 9 write wal--------------------------->|   |                           |                           |
|                                                               |                           |   | 10 startp                 |                           |
|                                                               |                           |   | 11 startup apply-launch ->|                           |
|                                                               |                           |   |                           | 12 read suscription       |
|                                                               |                           |   |                           | 13 calucate worker num    |
|                                                               |                           |   | <-------------------------| 14 register worker info   |
|                                                               |                           |   | 15 read bgworker info                                 |
|                                                               |                           |   | 16 startup apply-worker ----------------------------->|
| <-------------------------------------------------------------+---------------------------+-----------------------------------------------------------| 17 ask publication
| 18 receive connect                                            |                           |                                                           |
| 19 fork postgres as wal-sender ------------------------------>|                           |                                                           |
                                                                | 20 read wal <-------------|                                                           |
                                                                | 21 decod to decode-wal                                                                |
                                                                | 22 send decoded-wal ----------------------------------------------------------------->|
                                                                                                                                                        | 23 receive decoded-wal
                                                                                                                                                        | 24 apply decoded-wal
                                                                                                                                                        | (if is postgresql)
                                                                                                                                                        | 25 scan tuple from t1
                                                                                                                                                        | 26 get tuple pointer
                                                                                                                                                        | 27 mark tuple deleted
                                                                                                                                                        | 28 generate wal
3.3 数据格式
4 实现源码
上述流程中可以看到,逻辑复制由订阅端触发。此处,从订阅端开始,介绍复制流程:
4.1 订阅端:apply-launch
4.2 订阅端:apply-worker
4.3 发布端:postmaster
4.4 发布端:wal-sender
5 性能优化
5.1 现状
首先,以一个简单示例,介绍vastbase当前版本逻辑复制的工作流程,假设:有3个事务并行执行update, insert, delete等操作,复制流程如下:
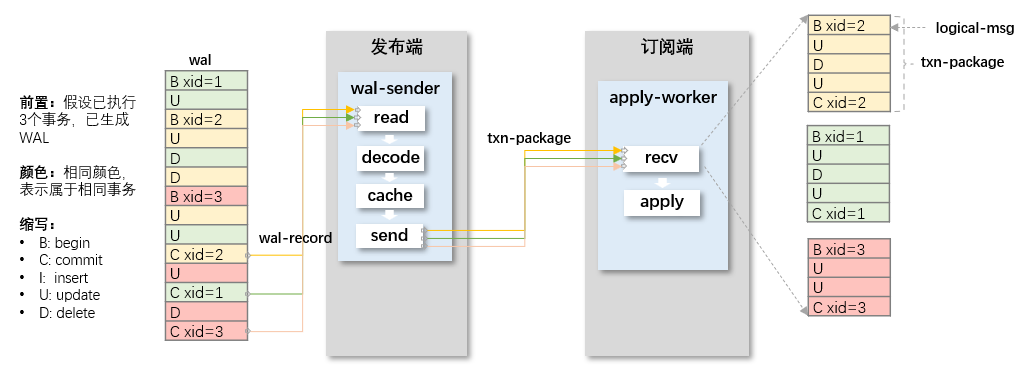
各关键步骤的解释如下:
- 发布端
- 生成wal: 执行事务,生成wal。产生wal的操作包括:begin, insert, update, delete, commit等
- 读取wal-reacord: wal-sender线程,按序读取wal-record
- 解码wal-record:wal-sender线程,提取wal-record中的关键信息,包括操作类型、tuple中的数据等逻辑信息,不包括filenode等物理信息,生成logical-msg。1条wal-record生成1条logic-msg
- 缓存logic-msg:生成logic-msg后,一般不直接发送,而是先缓存,达到特定条件才发送。属于同一事务的logical-msg缓存在一起
- 发送txn-package:当解码到commit transaction的wal-record时,发送一次txn-package,包含该事务所有的logic-msg
- 订阅端
- 接收txn-package:apply-worker线程,持续接收txn-package
- 回放logic-msg:从txn-package按序读取logic-msg中,解析操作类型、数据等,调用heapam层接口重放logical-msg
当前版本,几个关键设计如下:
- 发布端
- 生成wal
- 读取wal-record
- 解码wal-record
- 发送txn-package:
- 发送内容:发送3个txn-package,1个txn-packag包含1个事务的所有logical-msg
- 发送时机:解码到commit transaction的wal-record后
- 订阅端
- 接收txn-package:串行接收3个txn-package
- 回放logic-msg:串行回放txn-package中的所有logical-msg
5.2 优化方案
优化点一:发布端-流复制协议(逻辑数据)
从订阅段角度看,一次接收与处理一个事务的package,复制过程是串行的。
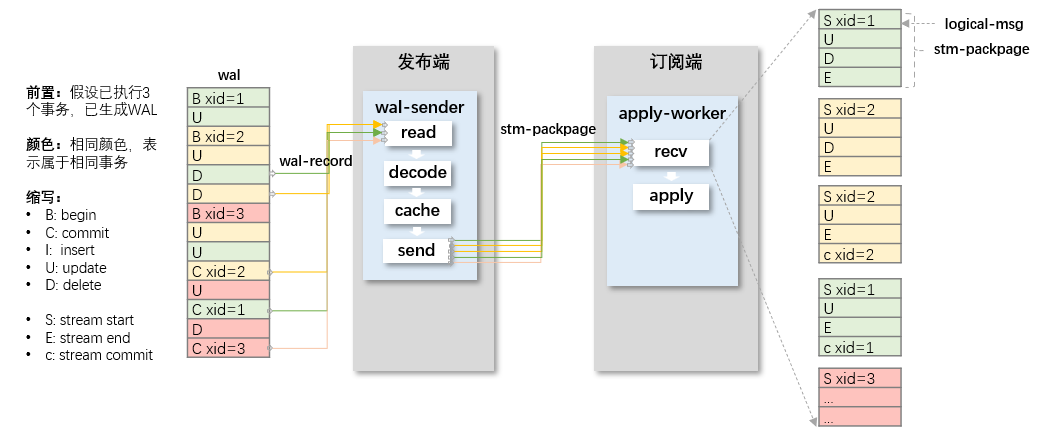
流复制协议,主要优化上述流程中的:发送txn-package、接收txn-package步骤,让发布端并行发送多个事务的logical-msg。即同一时刻,订阅端可能存在多个未提交的事务。
复制流程中,改动如下:
- 发布端
- 生成wal
- 读取wal-record
- 解码wal-record
- 发送stm-package:
- 发送内容:发送3个或更多的stm-package,1个stm-packag包含1个事务的部分logical-msg
- 发送时机:已缓存的logical-msg总大小达到阈值,以及解码到commit transaction的wal-record后
- 订阅端
- 接收stm-package:接收3个或更多的stm-package
- 回放logic-msg
流程图如下:
优化点二:订阅段-并行回放机制(逻辑数据)
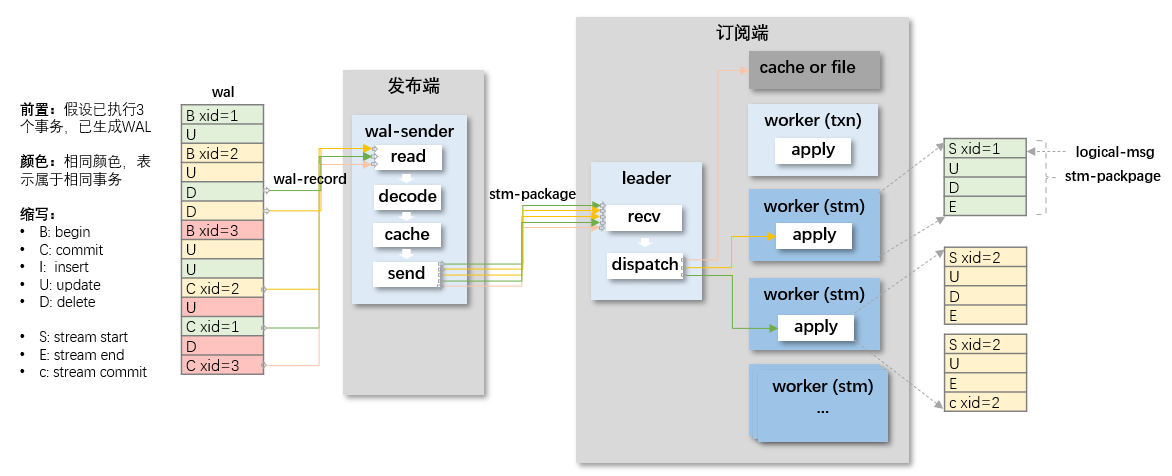
并行回放机制,主要优化上述流程中的:回放logical-msg步骤,让订阅端并行回放多个事务的logical-msg。流复制协议,让发布端并行发送事务数据,并行回放机制,依赖流复制协议。
复制流程中,改动如下:
- 发布端
- 生成wal
- 读取wal-record
- 解码wal-record
- 发送stm-package:
- 订阅端
- 接收stm-package:leader线程,持续接收stm-package,提取、记录事务信息,分发stm-package给worker,由worker完成apply。从package中提取xid,判断事务状态:
- 事务开始:(即本事务的第1个stm-package)
- 尝试申请1个空闲的worker,发送stm-package。之后,worker被该事务独占,只接收、回放本事务的stm-package,直到回放完事务commit或abort的logical-msg,才释放worer
- 如果没有空闲worker,stm-package会暂时缓存,等待空闲worker
- 事务进程中(即本事务的第2+个stm-package)
- 查找已占用的worer,发送stm-package
- 事务结束(package中commit/abort对应的logical-msg)
- 查找对应的worer,发送stm-package,等待对commit/abort的apply,才继续接收下一个package
- 事务开始:(即本事务的第1个stm-package)
- 回放logic-msg:worker线程,接收stm-package,提取logical-msg中的信息,调用heapam接口回放。
- 接收stm-package:leader线程,持续接收stm-package,提取、记录事务信息,分发stm-package给worker,由worker完成apply。从package中提取xid,判断事务状态:
流程图如下:
另外,事务并行后,需确保数据一致性。示例:在发布单,有事务1和2,更新同1个tuple,事务1先更新,事务wal日志如下:
B: 1
B: 2
U: 1 -- 先更新
C: 1
U: 2 -- 事务1提交后,才更新成功
C: 2
在并行回放场景,订阅端,必须确保:C:1限制,U:2后执行。当前方案中,解决该问题的设计如下:
- 发布端:解码到C后,直接发送
- 订阅端:接收到C后,等待C回放完成,再继续接收后续的logical-msg
另外,还有一些特殊场景,与核心设计无关,此处不展开讨论,比如:
- 混合机制:发布端同时发送stm-packpage和txn-package(订阅端启用1个txn-worker和多个stm-worker,txn-worker只处理txn-package)
- 抢占机制:收到stm-package,内含commit的logical-msg,但是,没有空闲的stm-worker,无法处理commit。(此时txn-worker是空闲的,抢占txn-worker)
优化点三:发布端-并行解码机制
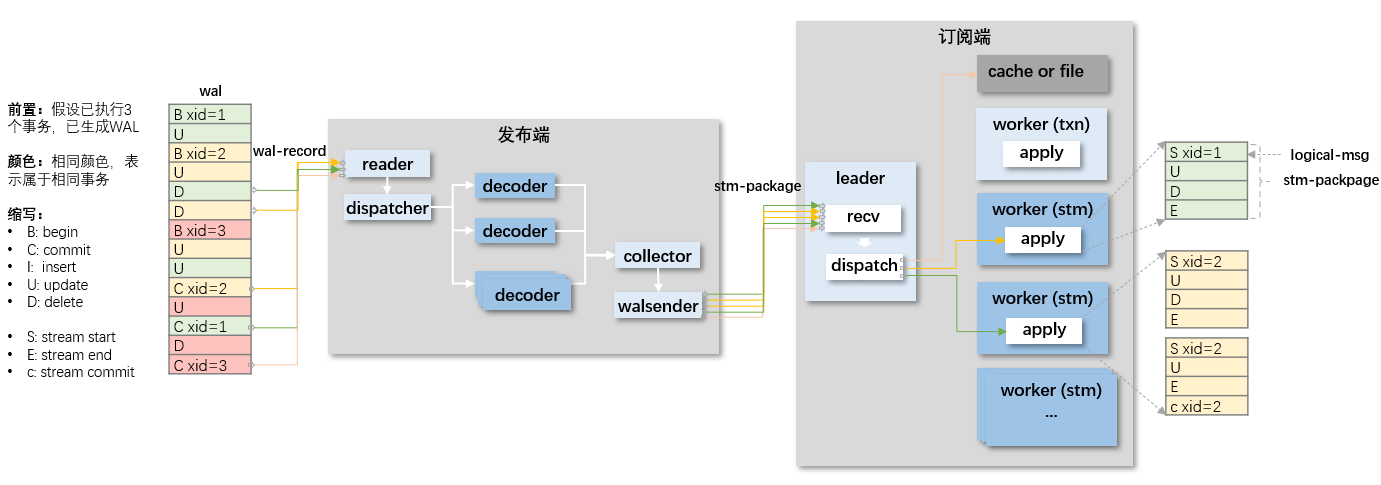
高并发场景,在发布端,有数百个线程执行事务并生成wal,而仅有1个线程解码wal。实现流复制协议、并行回放机制后,解码存在瓶颈,因此,需使用并行解码机制。
当前版本的vastbase中,已具备并行解码功能,只是无法用于逻辑复制场景,需额外改动适配。
复制流程中,改动如下:
- 发布端
- 生成wal
- 读取wal-record
- 以前,读取、解码、发送步骤,由1个wal-sender线程完成。现在,将读取、解码、发送等步骤,拆分为多个线程。该机制非本次新增,此处不再详细介绍。
- 解码wal-record
- 发送stm-package
- 订阅端
- 接收stm-package
- 回放logic-msg
最终,集成3个优化方案后,流程图如下:
目前,测试数据如下:
测试场景:tpcc
- 部署:单机
- warhouse:100
- 并发:400
- tpmc:约40w
测试结果
- 基线:
- 发布端wal生成速度:约100m/s
- 端到端逻辑复制:约10m/s
- 目标:
- 端到端逻辑复制:70-100m/s
- 优化后:
- 端到端逻辑复制:解码、发送、接收、多线程分发、并行回放(60-100个线程):约50m/s
- 订阅端只接收:解码、发送、接收:80+m/s
- 订阅端只多线程分发:解码、发送、接收、多线程分发:70+m/s
- 基线:
性能瓶颈
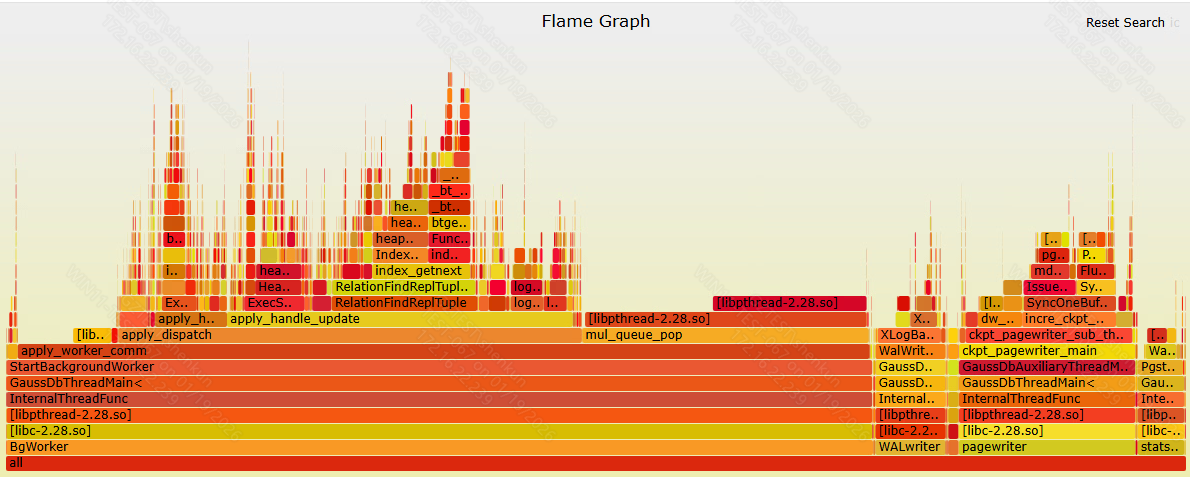
- worker饥饿:通过火焰图分析,订阅端的worker线程,大部分时候出于饥饿状态,需继续优化,充分利用worker线程。
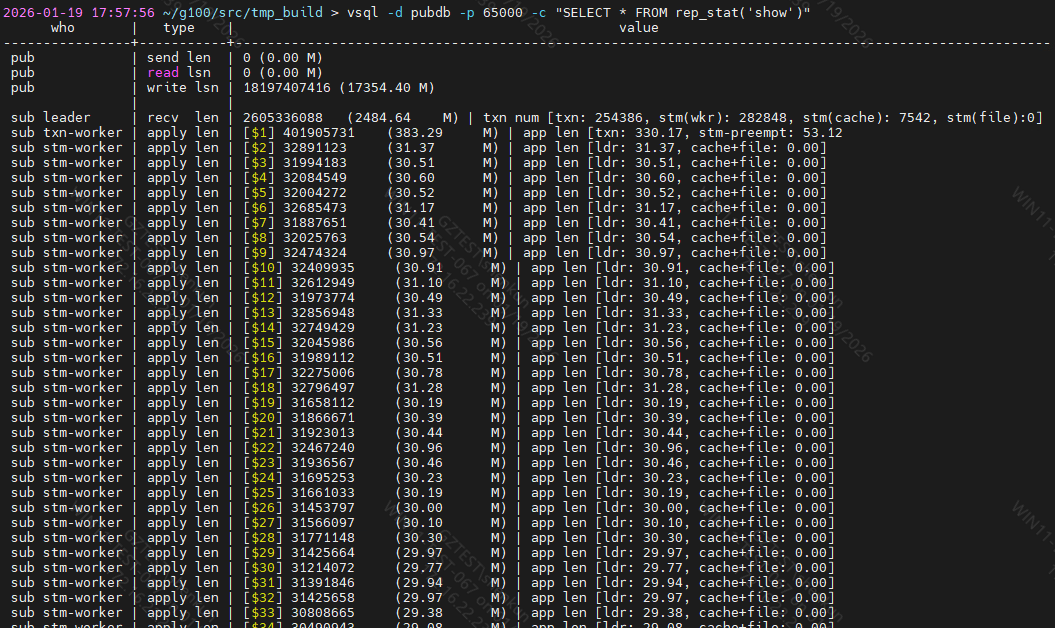
- 负载均衡:tpcc中,1个事务中执行的写操作,从5个到20+个不等,订阅端回放结果如下:
- worker饥饿:通过火焰图分析,订阅端的worker线程,大部分时候出于饥饿状态,需继续优化,充分利用worker线程。
5.3 未来方案
一、计划优化点一:发布端-事务提交等待
发布端解码事务commit日志后,判断订阅端进行中的事务量,如果事务较少,则先发送一批其他事务的stm-packpage,再发送commit的logical-msg