1 逻辑复制性能优化
1.1 功能简述
- 原理:
假设,发布端执行INSERT INTO t1 VALUES(1,'data1'),更改1行数据,产生1条wal日志。逻辑复制功能将读取这条wal,解码并生成1条message,将message发送至订阅端。订阅端应用这条message,等价于重新执行INSERT INTO t1 VALUES(1,'data1')。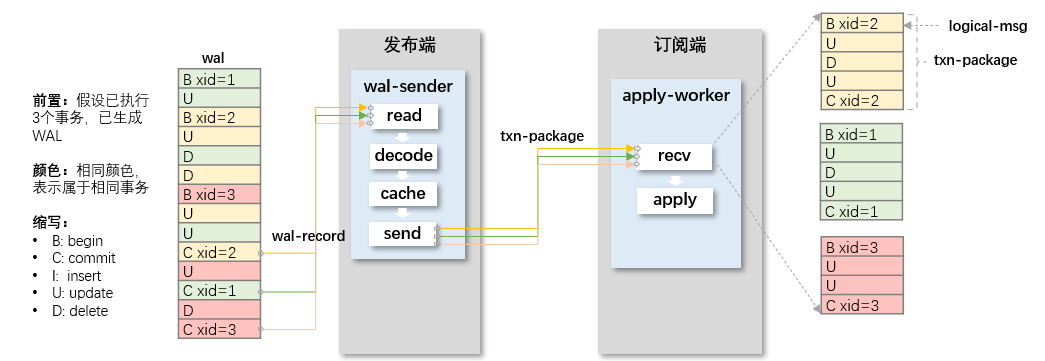
- 问题:
308.1 psu1以及之前版本,逻辑复制性能较低。以tpcc场景为例,40w tmpc时,发布端产生wal日志速度约100m/s,订阅端的复制速度约10+m/s。 - 客户:
滚动升级场景中,备机停机升级,主机持续执行业务,备机升级后使用逻辑复制追赶主机数据。长存客户场景,主机产生wal日志速度约40-50m/s,旧版本逻辑复制速度10+m/s,由于逻辑复制速度太慢,备机无法追赶主机,最终导致升级失败。 - 优化
本需求设计与实现并行逻辑复制机制,大幅提高逻辑复制速度,在上述场景中,订阅端速度可达到70-90m/s。并行逻辑复制分为3个关键子机制:- 发布端多线程并行解码
- 发布端与订阅端流复制传输协议
- 订阅端多线程并行应用
1.2 实现方案
本章分3个章节,分别介绍3个关键子机制。
1.2.1 发布端并行解码机制
在旧版本中,发布端采用串行解码机制,只有1个walsender线程,串行执行:1次读取1条wal日志,解码1条wal生成1条message,缓存或发送message。
旧版本代码中,发布端有实现并行解码的代码,但是,无法直接使用,订阅端只能是工具,不能是数据库实例,且存在大量问题。本需求基于旧版本并行解码,实现权限的并行解码机制。
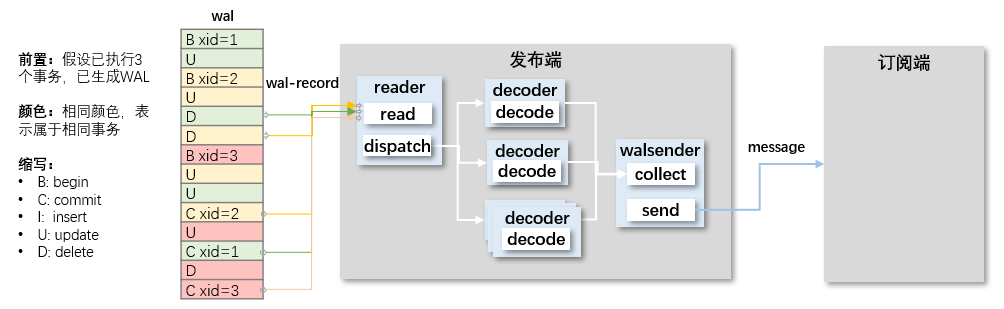
并行解码机制,将启动多个线程,包括1个reader、多个decoder、1个walsender,它们的功能如下:
- reader:1次读取1条wal日志,将wal发送给decoder
- decoder:1次接收1条reader发送的wal,解码生成message,将message发送给walsender
- walsender:1次接收1条decoder发送的message,将message发送给订阅端
线程架构图如下:
lsn 1-10
        d1 1 4  collect 阻塞 1
        d2 2 5               2
        d3 3 6               3
1.2.2 发布端与订阅端流复制协议
一、握手阶段
订阅端与发布端建立连接时,订阅端会根据CRETE SUBSCRIPTION语法设置的参数,生成连接命令,根据连接命令,发布端和订阅端决定采用哪种通信协议,究竟是采用事务复制协议(旧版本)还是流复制协议(新版本)。
事务复制协议(旧版本)
订阅端发送的连接命令如下:
START_REPLICATION SLOT "$slot_name" LOGICAL $start_lsn
    (proto_version '3', publication_names '"$publication_name"')
流复制协议(新版本)
如果CRETE SUBSCRIPTION时,指定worker_number>1,即启用并行逻辑复制机制,将使用新的连接命令,订阅端发送的连接命令如下:
START_REPLICATION SLOT "$slot_name" LOGICAL $start_lsn
    (proto_version '3', publication_names '"$publication_name"', streaming 'extreme', parallel-decode-num '20', max-recordbuffer-in-memory '100', max-txn-in-memory '100')
上述命令中新增了多个参数:
- 新增streaming参数:表示使用 流复制协议
- 新增parallel-decode-num、max-recordbuffer-in-memory、max-txn-in-memory:表示让发布端使用 并行解码机制,流复制协议吞吐率高,必须采用并行解码机制
当然,如果CRETE SUBSCRIPTION时不主动指定worker_number>1,则仍然使用旧版本的连接命令与协议,本需求保留并隔离了旧版本的协议,与新版本互不影响。
二、复制阶段
为方便理解,此处以一个实际的例子,介绍旧版本事务复制协议与新版本流复制协议的复制原理,并指出二者的区别。
假如,发布端执行2个事务,事务执行顺序如下:
| 时间 | 事务1 | 事务2 |
|---|---|---|
| 1 | begin | - |
| 2 | insert 1a | - |
| 3 | - | begin |
| 4 | - | insert 2a |
| 5 | update 1b | - |
| 6 | commit xid=1 | - |
| 7 | - | update 2b |
| 8 | - | commit xid=2 |
事务复制协议(旧版本)
针对上述示例场景,逻辑复制处理流程如下:(先产生wal,再解码,中间有时间差,为方便理解,此处假设产生后立即解码)
- 时间[2,4,5]:解码事务1和2的wal(begin不处理),不是commit对应的wal,都直接缓存
- 时间[6]:解码到commit xid=1,发送所有属于事务1的缓存。
一次性发送4条message,message类型分别为[B(自动生成), I, U, C],分别对应时间[2,5,6]产生的日志。
4条message统一格式如下:
+-----+-------------------------------+=========+===================+
| 'w' | dataStart | walEnd | sendTime | msgType | msgBody           |
+-----+-------------------------------+=========+===================+
                                      |--------实际的message内容-----|
                                        B/I/U/C
其中,msgType分别是[B, I, U, C],msgBody中是解码后的wal日志。’B’和’C’的message中,携带了事务的xid。’I’和’U’的message中,携带了数据。
- 时间[7]:解码事务2的wal,不是commit对应的wal,直接缓存
- 时间[8]:解码到commit xid=2,发送所有属于事务2的缓存。
- 一次性发送4条message,类型分别为[B(自动生成), I, U, C],分别对应时间[4,7,8]产生的日志。
- 格式同上
流复制协议(新版本)
针对上述示例场景,逻辑复制处理流程如下:
- 时间[2,4,5,6,7,8]:解码事务1和2的wal(begin不处理),并直接发送
分别发送6条message,message类型全是’F’,’F’是新增的message类型,表示流式message。
6条message统一格式如下:
+-----+-------------------------------+^^^^^^^^^^^^^^^^^^^^^^^^^+=========+===================+
| 'w' | dataStart | walEnd | sendTime | 'F'     | xid  | msgLen | msgType | msgBody           |
+-----+-------------------------------+^^^^^^^^^^^^^^^^^^^^^^^^^+=========+===================+
                                      |----------新增部分--------|-----旧版本的message内容------|
                                                                  B/I/U/C
在’F’ message中,新增了事务xid,后半段message与事务复制协议保持一致。
使用流复制协议,有2个优点:
- 提高吞吐:发布端启用并行解码,相同场景下,约40w tmpc时,事务复制协议吞吐为 80+m/s,流复制协议吞吐为 130+m/s
- 事务并行:从订阅端的角度看,在事务复制协议中,订阅端串行接收事务,无法判断事务2中,哪些操作在事务1commit之后的,无法实现事务并行。在流复制协议中,订阅端接收message的顺序,与发布端的wal日志顺序一致。属于事务2的操作,且在事务1commit之前的,可与事务1并行执行。
1.2.3 订阅端并行应用机制
整体架构
在旧版本中,订阅端采用串行应用机制,只有1个apply-worker线程,串行执行:接收message,应用message。
本需求设计并行应用机制机制,订阅端启用多个线程,包括1个apply-leader和多个apply-worker,它们的功能如下:
- apply-leader:使用流复制协议,接收来自发布端的message,接收顺序与发布端wal日志顺序一致。并且,维护各个事务的状态等信息,统一调度所有apply-worker,将message发送给apply-worker。
- apply-worker:接收由apply-leader分发的message,并直接应用。多个apply-worker之间可并行应用,即事务并行应用。1个apply-worker,只处理1个事务的message,只有该事务commit/abort后,才处理新事务的message。
线程架构图如下:
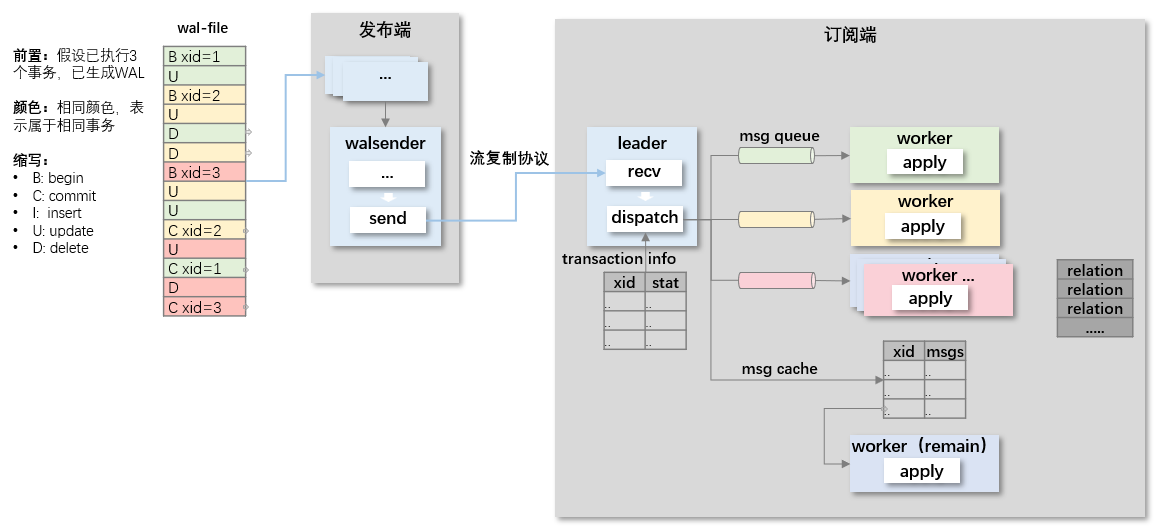
为方便理解,以一个简单示例,介绍并行的核心思路,例如,在发布端,以下2个事务同时执行:
-- 前置条件
create table t(c1 text);

-------------------------------------------------------------------------
-- 事务1                                    -- 事务2
-------------------------------------------------------------------------
begin; -- 1 (先开始)
insert into t values('1');
                                            begin;
                                            insert into t values('2');
insert into values ('3');
commit;
                                            insert into values ('4')
                                            commit;
并行apply的核心思路如下:
leader                       worker-1                       worker-2
+-------------------------------+-------------------------------+----------------------------------------
1. recv [xid=1, insert '1']
2. send ----------------------> |
3. recv [xid=2, insert '2']     | 1. apply [xid=1, insert '1']
4. send ------------------------------------------------------> |
5. recv [xid=1, insert '3']                                     | 1. apply [xid=2, insert '2']
6. send ----------------------> |
7. recv [xid=2, insert '4']     | 2. apply [xid=1, insert '3']
8. send ------------------------------------------------------> |
9. recv [xid=1, commit]                                         | 2. apply [xid=2, insert '2']
10. send ----------------------> |
11. recv [xid=2, comit      ]    | 3. apply [xid=1, commit]
12. send -----------------------------------------------------> |
                                                                | 3. apply [xid=2, commit]
但是,在并行apply的过程中,会遇到各类问题,本文分别讨论各类问题的处理方式。
一、数据一致性
在发布端,如果有多个事务同时执行,在订阅端,将启动多个apply-worker线程,每个线程对1个事务apply,达到并行apply的效果。
但是,订阅端需确保事务apply顺序与发布端一致,否则,会造成发布端、订阅端数据不一致。例如,在发布端,以下2个事务同时执行:
-- 前置条件
create table t(c1 text);

-------------------------------------------------------------------------
-- @事务x1                                   @-- 事务2
-------------------------------------------------------------------------
begin; -- 1 (先开始)
insert into t values('1'); -- 2
                                            begin; -- 3
                                            insert into t values('2'); -- 4
commit; -- 5
                                            update t set c1 = '3' where c1 = '1'; -- 6 (读已提交)
                                            commit; -- 7
insert '1';

begin; -- 1 (先开始)
insert into t values('1'); -- 2
                                            begin; -- 3
                                            insert into t values('2'); -- 4
                                            update t set c1 = '3' where c1 = '1'; -- 5 (读已提交)
commit; -- 6
                                            commit; -- 7
todo:5发给worker-2,但是5没执行,worker-1先执行6(1非主键,旧版本也有问题)
insert '1';

begin; -- 1 (先开始)
insert into t values('1'); -- 2
                                            begin; -- 3
                                            insert into t values('2'); -- 4
                                            update t set c1 = '3' where c1 = '1'; -- 5 (读已提交)
commit; -- 6
                                            commit; -- 7
示例中,第[2, 5, 6]步的insert, commit, update存在依赖关系,假如,在订阅端,第6步比第5步先apply,则update读不到未commit得数据,update执行结果与发布端不一致。
为解决此类问题,在订阅端,leader需通过调度机制,确保先apply上述示例中第5步的commit,再apply第6步的commit。
leader                       worker-1                       worker-2
+-------------------------------+-------------------------------+----------------------------------------
1. recv [xid=1, insert '1']
2. send ----------------------> |
                                | 3. apply [xid=1, insert '1']
4. recv [xid=2, insert '2']
5. send ------------------------------------------------------> |
                                                                | 6. apply [xid=2, insert '2']
7. recv [xid=1, commit]
8. send ----------------------> |
9. wait commit # 遇到commit,则阻塞等待,直到worker成功apply这条commit
                                | 10. apply [xid=1, commit]
    <-------------------------- | 11. send commit ok
12. recv [xid=2, update '1']
13. send -----------------------------------------------------> |
                                                                | 14. apply [xid=2, update '1']
15. recv [xid=2, commit]
16. send -----------------------------------------------------> |
17. wait commit
                                                                | 18. apply [xid=2, commit]
二、并行调度
在流复制协议中,每条msg都携带xid。apply-leader接收到msg时,需根据xid,找到负责该事务的worker。在该过程中,leader需解决以下问题:
- 事务缓存:比如worker数量较少,事务较多,无法为每个事务都分配worker,多余事务的msg将被缓存
- 线程调度:1个worker处理1个事务,当这个事务处理结束,leader会优先给worker分配缓存中的事务
- 线程预留:如果1个事务未分配到worker,所有该事务的msg被缓存,突然,收到了该事务的commit。为避免该问题,需要始终预留1个worker,用于处理缓存中的事务突然commit的情况。
leader的调度流程如下:
leader                                                            worker
+-------------------------------------------------------------------+-------------------------
1. 初始化hash表,用于记录所有事务的回放状态
2. 始终保留1个worker
                                                                    | 1. 阻塞等待leader发送msg
3. 从发布端接收msg
4. 从msg获取xid
5. 判断消息类型:
    if 'I' or 'U' or 'D':
        从hash表查找事务状态 hash.find(xid)
            if 未找到xid:(新事务)
                申请1个空闲worker
                    if 申请成功:
                        发送msg给worker worker.send(xid, msg) -----> (该worker将被xid对应的事务独占,直至xid对应的事务commit/rollback)
                                                                    | 2. 持续接收msg
                                                                    | 3. 应用msg
                        记录事务信息 hash.insert(xid, worker-id)
                    elif 申请失败:
                        暂时缓存msg
                        记录事务信息 hash.insert(xid, cache-id)
            elif 找到xid:(已开始的事务)
                if [xid, worker-id]:(已有worker处理该事务)
                    发送msg给worker worker.send(xid, msg) ----------->
                elif [xid, cache-id]:
                    继续缓存msg cache.put(xid, msg)
    elif 'C':
        从hash表查找事务状态 hash.find(xid)
        if [xid, worker-id]:
            发送msg给worker worker.send(xid, msg) ---------->
            阻塞等待worker提交事务 worker.wait()
                                                        <---------- | 4. 如果是'C'msg,应用成功后,向leader反馈
            让worker从缓存中读取1个事务的msg hash.next()
            hash.update(xid, cache-id -> worker-id)
        elif [xid, cache-id]:
            让保留的worker从缓存中读取本事务的msg worker.read(xid, worker-id)
    elif 'A':(abort)
        和'C'处理类似
三、流量控制
发布端walsender发送msg,订阅端leader接收msg,worker消耗msg,三者速度不一致,需进行流量控制。
- walsender速度 > leader速度:walsend通过系统调用send()发送msg,msg会占满网络缓存区,导致send()阻塞在内核态。
- leader速度 > worker速度:leader收到多余的msg后
- msg是新事务:无空闲worker,leader缓存msg,缓存达到阈值时,leader暂时停止接收msg,直到有空闲worker消耗缓存。leader最多可缓存1000个事务,1个事务的msg,如果超过1000条,则物化到临时文件中。
- msg属于worker中的事务:leader与worker的通信队列已满,leader暂时停止发送msg,直到worker消耗通信队列中的msg。通信队列最多可缓存1000个msg。
- leader速度 < worker速度:worker未收到新msg,通过信号量阻塞等待。
四、续点重传
在复制过程中,需实时记录复制进度,当发生重启等情况,重新复制时,需确保不会apply重复数据,或者漏apply数据。断点主要由订阅端维护。
假如,在发布端,3个事务同时执行:
+-----+-------------+-------------+-------------+
| lsn | xid=1       | xid=2       | xid=3       |
+-----+-------------+-------------+-------------+
| 1   | insert '11' |             |             |
| 2   |             | insert '21' |             |
| 3   |             |             | insert '31' |
| 4   | commit      |             |             |
| 5   |             | insert '22' |             |
| 6   |             | commit      |             |
| 7   |             |             | insert '32' |
| 8   |             |             | commit      |
+-----+-------------+-------------+-------------+
todo: 发布端并发高:多测断点续传
restart_lsn: commit=50

worker-1        worker-2     worker-3
----------------+--------------+-----------
                                insert lsn=80
                                commit
insert
                insert lsn=99
commit lsn=100
针对上述示例,假设订阅端apply lsn=7之后,发生故障:
leader                                      worker                           worker                            worker
+---------------------------------------------+---------------------------------+---------------------------------+--------------------
| 1. recv [lsn=1, xid=1, insert '11'] ------> | 1. apply [lsn=1]
           lsn表示:在发布端,本条msg对应的wal的lsn
| 2. recv [lsn=2, xid=2, insert '21'] ----------------------------------------> | 2. apply [lsn=2]
| 3. recv [lsn=3, xid=3, insert '31'] --------------------------------------------------------------------------> | 3. apply [lsn=3]
| 4. recv [lsn=4, xid=1, commit ]     ------> | 5. apply [lsn=4, commit]
                                              | 6. write wal [commit, lsn=4]
                                                所有commit对应的wal中,都会记录在发布端本条commit对应的lsn,这个lsn,就是断点,即只有commit的wal记录断点
| 7. recv [lsn=5, xid=2, insert '21'] ----------------------------------------> | 7. apply [lsn=5]
------- 8. checkpoint (上一次commit,对应的lsn=4)
| 9. recv [lsn=6, xid=2, commit]      ----------------------------------------> | 10. apply [lsn=6, commit]
                                                                                | 11. write wal [commit, lsn=6]
| 12. recv [lsn=7, xid=3, insert '31'] -------------------------------------------------------------------------> | 12. apply [lsn=7]
------- 13. 发生故障,重启

# 重启
startup
+--------------------------------------------------------+
| 1. read checkpoint [lsn=4], set breakpoint: [lsn=4]
| 2. redo [commit, lsn=6], update breakpoint: [lsn=6]
| 3. redo finish, breakpoint: lsn=6

# 重启后,订阅端向发布端发送断点
leader                                      worker                           worker                            worker
+---------------------------------------------+---------------------------------+---------------------------------+--------------------
| 1. start replication [lsn=6]
| 2. recv [lsn=3, xid=3, insert '31'] --------------------------------------------------------------------------> | 2. apply [lsn=3]
     # 在断点前,所有未commit事务的msg,都会重发
| 3. recv [lsn=7, xid=3, insert '31'] --------------------------------------------------------------------------> | 3. apply [lsn=7]
     # 在断点后,则按序发送所有msg,开始正常的逻辑复制
| 4. recv [lsn=8, xid=3, commit]      --------------------------------------------------------------------------> | 4. apply [lsn=8, commit]
| 5. ....

# 发布端,接收断点后,过滤无需重发的wal
walsend
+-------------------------------------------
| 1. recv breakpoint [lsn=6]
| 2. read [lsn=1, xid=1, insert '11']
|       3. cache {xid=1, lsn=1}
| 4. read [lsn=2, xid=2, insert '21']
|       5. cache {xid=2, lsn=2}
| 6. read [lsn=3, xid=2, insert '31']
|       7. cache {xid=3, lsn=3}
| 8. read [lsn=4, xid=1, commit]
|       9. commit lsn = 3 < breakpoint = 6, remove cache {xid=1, ..}
| 10. read [lsn=5, xid=2, insert '21']
|       11. cache {xid=2, lsn=2, lsn=5}
| 12. read [lsn=6, xid=2, commit]
|       13. commit lsn = breakpoint = 6, remove cache {xid=2, ..}
| 14. send all cache {xid=3, lsn=3} ---------------->
      # 处理至断点,一次性发送所有缓存,缓存中只剩下了未提交的事务
| 15. read [lsn=7, xid=3, insert '32']
|       16. send [lsn=7] ------->
        # 断点之后,读1条,发1条,不再需要缓存,开始正常逻辑复制
| 17. ....
1.3 接口说明
- 用户需调大3个guc的取值:max_replication_slots,max_background_workers,max_logical_replication_workers。
- CREATE/ALTER SUBSCRIPTION语法:WITH子句中,新增worker_number参数,控制并行应用机制的并行度。
- pg_subscription系统表:新增1列subwkrnum,int32类型
1.4 内存管理
无
1.5 安全
对外接口中,只在已有CREATE/ALTER SUBSCRIPTION语法中新增参数,不涉及变更权限,无需重新适配审计。
1.6 性能
之前,在优化发布端传输速度前,自测性能如下(实际性能应该高于一下数据,滚动升级场景,50并发,订阅端速度能稳定在80+m/s,峰值能到90-100m/s):
| 编号 | tpcc并发数 | tpmc (10min) | tpmTotal | 发布端速度 | 订阅端速度(2次抽样) |
|---|---|---|---|---|---|
| 1 | 10 | 5.8w | 12.9w | 13.4 m/s | 52.2 m/s |
| 2 | 50 | 21.8w | 48.6w | 50.9 m/s | {76.4, 77.3} m/s |
| 3 | 100 | 33.3w | 73.9w | 77.5 m/s | {74.0, 73.2} m/s |
| 4 | 200 | 35.4w | 78.7w | 82.8 m/s | {73.8, 70.7} m/s |
| 5 | 300 | 36.3w | 80.9w | 84.9 m/s | {66.4, 64.0} m/s |
| 6 | 400 | 32.6w | 72.6w | 76.4 m/s | {62.1, 60.8} m/s |
- 测试环境:单机,kunpeng-920,128核,760G内存,tpcc 100 warehousee
- 发布端速度:tpcc运行10min,(结束lsn - 开始lsn) / 600s
- 订阅端速度:启动复制,抽样:(第130s的lsn - 第30s的lsn) / 100s,(第230s的lsn - 第130s的lsn) / 100s
1.7 专利
无
1.8 升级管理
- 用户需调大3个guc的取值:max_replication_slots,max_background_workers,max_logical_replication_workers。
- CREATE/ALTER SUBSCRIPTION语法中,需主动指定worker_number>0,才会启用并行逻辑解码,升级后逻辑复制默认行为不发生变化
- pg_subscription系统表:新增1列subwkrnum,int32类型
1.9 其他说明
无