1 简介
1.1 目的
逻辑复制是一种在多个数据库实例之间复制数据的功能,通常用于从一个数据库实例中,将针对指定表的insert、delete、update等写操作,复制到其他另一个数据库实例。在数据库术语中,统一称逻辑复制的发送方为发布端,称接收方为订阅端。Oracle、Postgresql、Vastbase等数据库产品,均提供逻辑复制功能。
当前版本,逻辑复制性能较低。以tpcc场景为例,发布端40w tmpc时,产生wal日志速度约100+m/s,订阅端的复制速度约10+m/s。在滚动升级场景,主机和备机可能是不同的产品版本,主备复制数据时,不能使用物理复制,只能使用逻辑复制。在长存客户场景中,主机产生wal日志速度在50+m/s左右,备机使用逻辑复制,复制速度约10+m/s,备机将追赶不上主机进度,导致滚动升级失败。
主a                     备b                         备c
+-----------------------+---------------------------+-----------------------------
|1 ==>执行业务
|2 开始滚动升级,暂停流复制 lag=400M
                        |3 暂停流复制(物理复制)
|4 创建逻辑复制槽 lsn1=1G
                        |5 恢复流复制
                        |6 物理复制追赶,到逻辑复制槽
                        |6 开始单节点升级
                        |7 [升级] 停止进程
                        |8 [升级] 替换二进制等
                        |9 [升级] 启动进程
                        |10 单节点升级成功
|11 持续执行业务 lsn2=2G
                        |12 创建订阅,启动逻辑复制,lsn1=1G
                        |13 逻辑复制开始追赶(初始差距:lsn2-lsn1)
|14 持续执行业务 lsn3=2.5G
                        |15 逻辑复制持续追赶 lsn=1.6G
|16 (可重置lag)
                        |17 差距持续缩小(从lsn2-lsn1降低到lag)
|18 发送停机命令
|19 停止业务
                        |20 差距持续缩小,从lag缩小至0
|21 停止进程成功
因此,需大幅提高逻辑复制速度,在长存客户场景中,逻辑复制速度至少需达到70+m/s。目前,发布端、订阅端均存在性能瓶颈,均需要优化。
1.2 适用范围
G100 3.0.9 psu2及之后版本
1.3 术语定义、首字母缩写词和缩略语
- 发布端:逻辑复制场景,发送数据方。
- 订阅端:逻辑复制场景,接收数据方。
1.4 参考资料
- Vastbase G100产品文档中逻辑复制使用介绍:https://docs.vastdata.com.cn/zh_CN/VastbaseG100/V3.0.8/1/f5c2ae8eb9744d429ad39c02438addf6
- oracle goldengate并行复制:https://oracle.hydrogen.sagittarius.connect.product.adaptavist.com/en/database/goldengate/core/26/coredoc/replicat-parallel-replicat.html#GUID-F1CD8E03-8DA1-4A78-95D3-C0516F1DA09A
2 逻辑复制性能优化
2.1 功能简述
一、逻辑复制使用示例
使用逻辑复制,可概括为3个阶段:
一、配置参数
通过GUC参数,配置wal日志级别,身份认证等参数--==[发布端]==-- gs_guc set -D $PGDATA -c 'wal_level=logical' gs_guc set -D $PGDATA -h "host all all 0.0.0.0/0 md5" gs_guc set -D $PGDATA -h "host replication all 0.0.0.0/0 md5" vb_ctl restart -D $PGDATA --==[订阅端]==-- gs_guc set -D $PGDATA -c 'max_replication_slots=16' gs_guc set -D $PGDATA -c 'max_background_workers=16' gs_guc set -D $PGDATA -c 'max_logical_replication_workers=16'二、创建表
--==[发布端]==--
CREATE TABLE pt1(c1 INT,c2 TEXT);
CREATE TABLE pt2(c1 INT, c2 TEXT);

--==[订阅端]==-- 表结构需要与发布端一致
CREATE TABLE pt1(c1 INT,c2 TEXT);
CREATE TABLE pt2(c1 INT, c2 TEXT);
三、创建发布订阅
--==[发布端]==--
-- 1. 创建发布:指定哪些表需复制
CREATE PUBLICATION pub1 FOR TABLE pt1,pt2;
-- 2. 创建复制槽:存储复制状态等信息
SELECT pg_create_logical_replication_slot('pslot1', 'pgoutput');
-- 3. 创建用户:订阅端通过该用户连接发布端,以进行数据传输
CREATE USER pu1 REPLICATION SYSADMIN LOGIN ENCRYPTED PASSWORD 'pu1.12345';
GRANT ALL ON pt1,pt2 TO pu1;

--==[订阅端]==--
-- 1. 创建订阅
CREATE SUBSCRIPTION sub1 CONNECTION 'host=172.16.103.90 port=64001 dbname=pubdb user=pu1 password=pu1.12345'  PUBLICATION pub1 WITH (create_slot=false, slot_name = 'pslot1', copy_data = false);
-- 2. 单独存储访问发布端的用户密码
gs_guc generate -S 'pu1.12345' -D $GAUSSHOME/bin -o subscription
四、复制数据
--==[发布端]==--
-- 1. 变更数据
BEGIN;
INSERT INTO pt1 VALUES (1, 'data1');
UPDATE pt1 SET c2 = 'data2' WHERE c1 = 1;
COMMIT;
SELECT * FROM pt1;

--==[订阅端]==--
-- 1. 查询数据:预期查询结果与发布端保持一致
SELECT * FROM pt1;
二、逻辑复制基本原理
为清晰的理解本需求,需简单了解逻辑复制基本原理。逻辑复制,本质是复制解码之后的wal。此处,如下图所示,以一个实际场景为例,梳理完整的复制流程: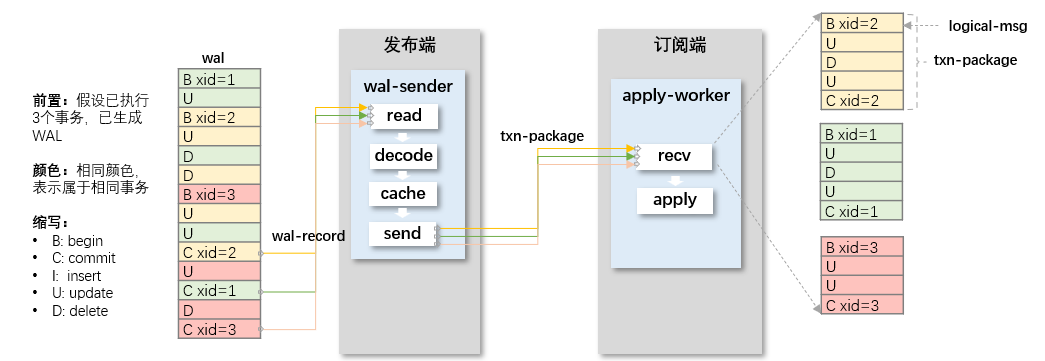
上图中,关键流程如下:
- 发布端
- (1) 生成wal-record
应用执行insert、delete、update、commit等语句,变更1行数据时,都会生成1条wal-reocrd,记录变更信息:变更类型、数据等。 - (2) 解码wal-record
启动1个wal-sender线程,按顺序读取insert、delete、update对应的wal-record,进行解码,即提取变更信息,生成logical-wal-record,并暂时缓存。 - (3) 发送logical-wal-record
wal-sender线程读取到commit对应的wal-record后,解密并发送缓存中所有属于本事务的logical-wal-record,即以事务为粒度发送。
- (1) 生成wal-record
- 订阅端
- (4) 接收loigcal-wal-record
启动1个apply-worker线程,持续接收事务的完全logical-wal-record。 - (5) 重放logical-wal-record
apply-worker从logical-wal-record中,提取变更信息:变更类型、数据等,将其看做单条insert、delete、update、commit语句并执行。
- (4) 接收loigcal-wal-record
针对上述流程,本需求设计并行逻辑复制机制,该机制主要包括3个子机制:
- (2) 解码wal-record:完善并行解码子机制,将1个wal-sender线程拆分为多个线程,实现多线程并行解码。
- (3) 发送logical-wal-record:设计流复制协议,替换以事务为粒度的发送机制,改为以logical-wal-record为粒度的发送机制。
- (5) 重放logical-wal-record:设计并行应用子机制,将1个apply-worker线程,拆分为多个apply-worker线程,实现并行应用。
2.2 功能说明
2.2.1 使用流程
场景一:使用并行逻辑复制机制
本需求重点在于提高逻辑复制性能,非功能类需求,对用户接口改动较少。为突出重点,避免内容冗余,本章只介绍新版本与旧版本逻辑复制相比,存在变化的使用流程。
一、配置参数
--==[发布端]==-- 无变化 --==[订阅端]==-- gs_guc set -D $PGDATA -c 'max_replication_slots=400' gs_guc set -D $PGDATA -c 'max_background_workers=400' gs_guc set -D $PGDATA -c 'max_logical_replication_workers=400'- 旧版本:在订阅端,旧版本只采用1个线程apply数据
- 新版本:在订阅端,并行应用子机制采用多线程apply数据,因此,需增大与最大线程数相关的guc取值。
二、创建表
--==[发布端]==--
无变化

--==[订阅端]==--
无变化
三、创建发布订阅
--==[发布端]==-- 无变化 --==[订阅端]==-- CREATE SUBSCRIPTION $subname CONNECTION '.. sslmode=disable' PUBLICATION $pubname WITH (worker_number=100); -- 以前:sslmode=prefer:发布端开了ssl,就走ssl,否则不走 -- 预期:worker_number>1时,启用并行逻辑复制 -- 查看worker_number取值 SELECT subwkrnum FORM pb_subscription;- 旧版本:在订阅端,旧版本只采用1个线程apply数据
- 新版本:
- 多线程:在订阅端,并行应用子机制采用多线程apply数据,因此,需提前配置apply线程数。(理论上,假如发布端100个事务同时执行,worker_number=100时,复制性能最高;worker_number>100,复制性能与worker_number=100没区别;worker_number<100,取值越小则性能越低)
- ssl:开启ssl后,发布端、订阅端加密传输数据,传输性能低,约40+m/s,影响整体复制性能。为提高并发性能,需设置sslmode=disable。
四、复制数据
--==[发布端]==--
无变化

--==[订阅端]==--
无变化(使用方式不变,复制速度变快)
在创建订阅时,如果设置了worker_number>1,则在复制数据时,同时启用:并行解码机制、流复制协议、并行应用机制。本需求未向用户提供额外接口。
- 旧版本:tpcc中,tmpc约40w,发布端产生wal日志速度为100m/s,逻辑复制速度约10-15m/s
- 新版本:相同场景,发布端tpcc并发数低于400时,逻辑复制速度约70-90m/s
扩展场景一:集群启停
旧版本中,发布端、订阅端均只有1个线程参与复制。新版本中,发布端、订阅端均有多个线程参与复制,停止集群时,需确保所有线程正常停止。
测试流程如下:
- 一、配置参数
- 二、创建表
- 三、创建发布订阅
- 四、复制数据
- 五、进程停止
- vb_ctl stop停止发布端
- vb_ctl stop停止订阅端
扩展场景二:续点重传
旧版本中,订阅端只有1个apply-worker线程,该线程维护复制进度。新版本中,多个线程并行复制,修改了维护复制进度的机制,因此,新版本需对该场景进行覆盖测试。
测试流程如下:
- 一、配置参数
- 二、创建表
- 三、创建发布订阅
- 四、复制数据
- 五、进程重启
在复制过程中,可手动构造以下几类场景:- vb_ctl restart重启发布端,然后让订阅端重新建连
- vb_ctl restart重启订阅端
- kill -9异常终止发布端并重启,然后让订阅端重新建连
- kill -9异常终止订阅端并重启
预期结果:重启后,发布端与订阅端之间可正常复制数据,不会因重启导致数据丢失、数据重复等数据不一致的问题。
扩展场景三:初始快照复制
旧版本中,订阅端在初始快照复制阶段,只有1个apply-worker与复制线程进行交互,共同维护每个表的复制进度。新版本中,多个线程并行复制,修改了初始快照复制的机制,因此,新版本也需对该场景进行覆盖测试。
测试流程如下:
一、配置参数
二、创建表
三、创建发布订阅
--==[发布端]==--
无变化

--==[订阅端]==--
-- 1. 创建订阅:设置copy_data=true,启用初始快照复制机制
CREATE SUBSCRIPTION .. PUBLICATION .. WITH (worker_number=100, copy_data=true);
四、复制数据
--==[发布端]==--
无变化

--==[订阅端]==--
-- 1. 实时监测:查询系统表pg_subscription_rel,观察srsubstate列,当所有表的状态都变为'r',则表示初始快照复制完成,否则,表示正在进行初始快照复制
SELECT * FROM pg_subscription_rel;
-- 2. 增量复制:初始快照复制完成后,进行增量逻辑复制,即普通逻辑复制
-- 3. 校验数据:检查发布端、订阅端数据是否一致,确保初始快照复制机制未出问题(预期:发布端、订阅端数据一致)
扩展场景四:修改Subscription
在订阅端,修改subscription时,可能会触发启动、停止apply-worker线程,重置线程参数等,因此,需覆盖以下场景:
- ALTER SUBSCRIPION
- DROP SUBSCRIPTION
2.2.2 配置参数和文件
- 用户需调大3个guc的取值:max_replication_slots,max_background_workers,max_logical_replication_workers。
- CREATE SUBSCRIPTION语法:WITH子句中,新增worker_number参数,控制并行应用机制的最大并行度。
2.2.3 数据相关性
新增并行应用机制,启用多个apply-worker线程,线程数由guc参数max_replication_slots,max_background_workers,max_logical_replication_workers控制。
2.3 接口信息
- 用户需调大3个guc的取值:max_replication_slots,max_background_workers,max_logical_replication_workers。
- CREATE SUBSCRIPTION语法:WITH子句中,新增worker_number参数,控制并行应用机制的并行度。
- pg_subscription系统表:新增1列subwkrnum,int32类型
2.4 正反向行为
2.4.1 生效说明
CREATE SUBSCRIPTION .. PUBLICATION .. WITH (worker_number=..); 语法中,worker_number取值较大时,与不设置worker_number相比,复制性能有较大提升。
2.4.2 提示信息
在订阅端,观察wal日志的增长速度,可衡量复制速度。
2.4.3 约束和依赖
- 并行应用机制:CREATE/ALTER SUBSCRIPTION .. PUBLICATION .. WITH (worker_number=..)语法中,worker_number最大取值为400。所有SUBSCRIPTION中的worker_number总和需小于3个guc的取值:max_replication_slots,max_background_workers,max_logical_replication_workers。(但是,g100存在bug,当3个guc取值超过500时,多个地方可能出现core)
2.5 安全性
2.5.1 权限控制
对外接口中,只在已有CREATE/ALTER SUBSCRIPTION语法中新增参数,不涉及变更权限。
2.5.2 审计
对外接口中,只在已有CREATE/ALTER SUBSCRIPTION语法中新增参数,无需重新适配审计。
2.6 影响范围
2.6.1 对已有UDT,UDF, ECPG的影响
无
2.6.2 对系统函数的影响
无
2.6.3 对系统CATALOG的影响
pg_subscription系统表,新增1列subwkrnum,存储并行应用机制中的apply-worker数量。
2.6.4 对xlog日志格式、数据格式的影响
设计流复制协议,与旧版本复制协议区别如下:
- 发布端发送时机
- 旧版本:读取与解码到commit对应的wal-record时,发送事务对应的所有logical-wal-record
- 新版本:实时发送logical-wal-record
- 发布端发送格式
旧版本:假如1个事务执行:begin, insert, update, commit,发布端解码到commit时,会一次性发送4条消息。4条消息类型分别是[‘B’, ‘I’, ‘U’, ‘C’],每条消息统一格式如下:
+-----+-------------------------------+---------+-------------------+
| 'w' | dataStart | walEnd | sendTime | msgType | msgBody           |
+-----+-------------------------------+---------+-------------------+
                                        msgType取值范围:{B, C, I, U, D, ..}
                                        其中,'B' 消息携带事务id
新版本:假如1个事务执行:begin, insert, update, commit,发布端实时发送消息,不等待commit,发送3条’F’消息,’F’消息中会封装旧版本的’I’, ‘U’, ‘C’消息的内容,另外,每条’F’消息都携带事务信息。’F’消息的格式如下:
# 新版本:新增msgType:'F'
+-----+-------------------------------+*************************+---------+-------------------+
| 'w' | dataStart | walEnd | sendTime | 'F'     | xid  | msgLen | msgType | msgBody           |
+-----+-------------------------------+*************************+---------+-------------------+
                                                                msgType取值范围:{C, I, U, D, ..}
                                    原来msgType处,设置为'F'类型,表示flow类型的消息,即流复制协议。不使用'S',方便与pg的流复制协议区分。
                                    每条消息,需额外携带xid信息。
2.6.5 与其他功能交互时的行为表现
无
2.6.6 版本兼容性
订阅端与发布端建立连接时,订阅端会根据CRETE SUBSCRIPTION语法设置的参数,生成连接命令。
旧版本,订阅端发送的连接命令如下:
START_REPLICATION SLOT "$slot_name" LOGICAL $start_lsn
    (proto_version '3', publication_names '"$publication_name"')
新版本中,如果CRETE SUBSCRIPTION时,指定worker_number>1,即启用并行逻辑复制,订阅端发送的连接命令如下:
START_REPLICATION SLOT "$slot_name" LOGICAL $start_lsn
    (proto_version '3', publication_names '"$publication_name"', streaming 'extreme', parallel-decode-num '20', max-recordbuffer-in-memory '100', max-txn-in-memory '100')
    -- 新增streaming参数:表示使用 流复制协议
    -- 新增parallel-decode-num、max-recordbuffer-in-memory、max-txn-in-memory:表示让发布端使用 并行解码机制
新版中,如果不主动指定worker_number>1,则仍然使用旧版本的机制、协议,本需求保留并隔离了旧版本的串行解码机制,完全不受并行解码机制影响。
2.6.7 用户行为变更
新增支持并行逻辑复制机制,扩展CRETE SUBSCRIPTION语法,新增worker_number参数,用于控制并行复制的线程数,合理配置worker_number取值,可大幅提高逻辑复制速度。
另外,如果worker_number设置的较大,则需提高订阅端max_replication_slots、max_background_workers、max_logical_replication_workers这3个guc参数的取值。
pg_subscription系统表新增1列subwkrnum。
2.7 指标相关
2.7.1 关键资源指标
- cpu:订阅端启动50-400个apply-worker线程,cpu占用率约5%-15%。
- 内存:发布端内存占用变小,修改前发布端缓存所有未提交事务,修改后发布端不缓存事务。订阅端内存占用变大,无空闲apply-worker时,发布端会缓存数据。
- 外存:订阅端无空闲apply-worker时,缓存的事务数量超过1000后,会物化数据。
2.7.2 系统性指标
无
2.7.3 性能指标
之前,在优化发布端传输速度前,自测性能如下(实际性能应该高于以下数据,滚动升级场景,50并发,订阅端速度能稳定在80+m/s,峰值能到90-100m/s):
| 编号 | tpcc并发数 | tpmc (10min) | tpmTotal | 发布端速度 | 订阅端速度(2次抽样) |
|---|---|---|---|---|---|
| 1 | 10 | 5.8w | 12.9w | 13.4 m/s | 52.2 m/s |
| 2 | 50 | 21.8w | 48.6w | 50.9 m/s | {76.4, 77.3} m/s |
| 3 | 100 | 33.3w | 73.9w | 77.5 m/s | {74.0, 73.2} m/s |
| 4 | 200 | 35.4w | 78.7w | 82.8 m/s | {73.8, 70.7} m/s |
| 5 | 300 | 36.3w | 80.9w | 84.9 m/s | {66.4, 64.0} m/s |
| 6 | 400 | 32.6w | 72.6w | 76.4 m/s | {62.1, 60.8} m/s |
- 测试环境:单机,kunpeng-920,128核,760G内存,tpcc 100 warehousee
- 发布端速度:tpcc运行10min,(结束lsn - 开始lsn) / 600s
- 订阅端速度:启动复制,抽样:(第130s的lsn - 第30s的lsn) / 100s,(第230s的lsn - 第130s的lsn) / 100s
2.8 测试建议
本次修改,几乎重写了逻辑复制大部分流程,发布端、订阅端、传输协议等修改率超过60%,因此,原有逻辑复制功能,可能都需要覆盖测试。